

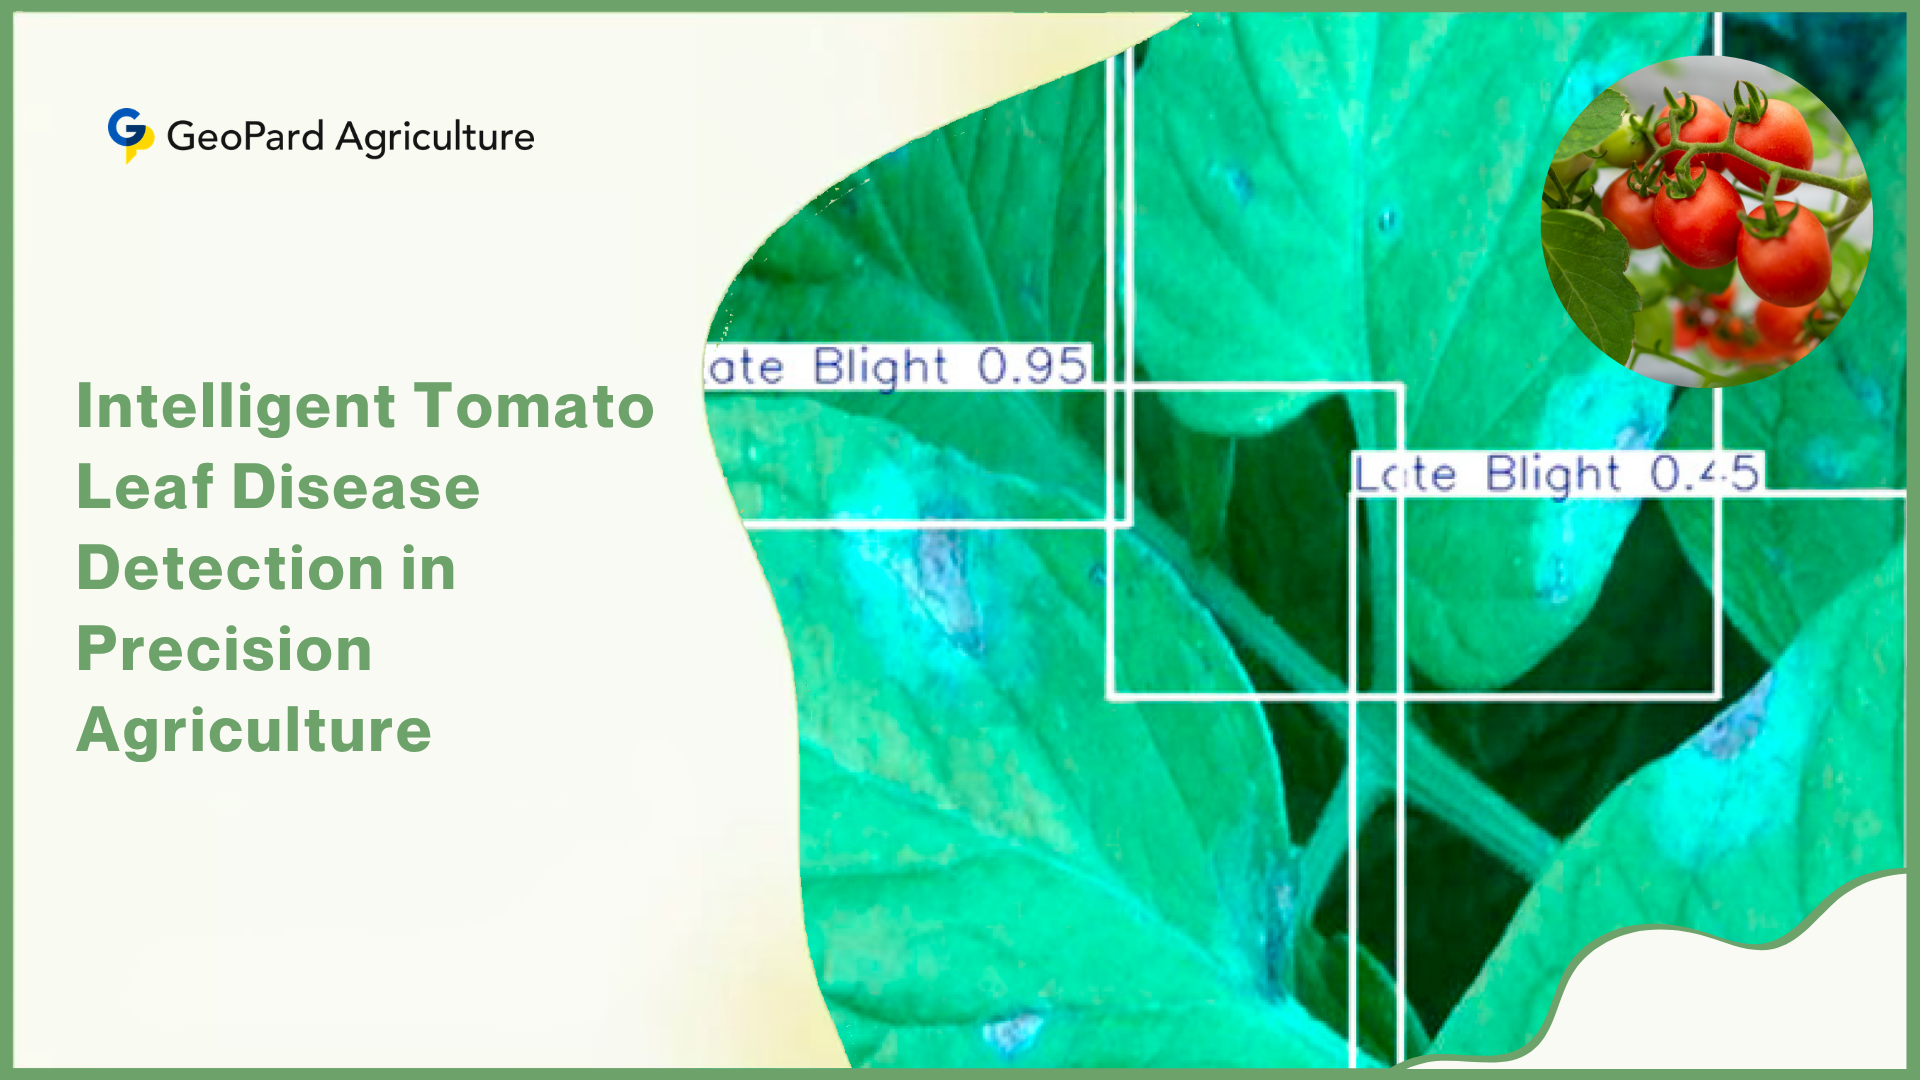
Die intelligente Erkennung von Tomatenblattkrankheiten steht im Schnittpunkt zweier starker Kräfte, die die globale Landwirtschaft grundlegend verändern: die wirtschaftliche Bedeutung des Tomatenanbaus selbst und die rasante Weiterentwicklung der Computer-Vision-Technologie. Tomaten sind die weltweit am häufigsten angebaute Gemüsepflanze; die Produktion erstreckt sich über 5 Millionen Hektar in mehr als 170 Ländern.
Blattkrankheiten allein vernichten jede Saison einen erheblichen Teil des Ertrags, und die herkömmliche Sichtprüfung durch Landarbeiter ist zu langsam, zu unzuverlässig und zu kostspielig, um sie flächendeckend durchzuführen. Präzisionslandwirtschaft mit KI-Unterstützung bietet hier eine bessere Lösung. Dieser Leitfaden deckt das gesamte Spektrum der intelligenten Erkennung von Blattkrankheiten bei Tomaten ab – von den biologischen Grundlagen bis hin zu modernsten Architekturen.
Warum Tomatenanbau und Krankheitserkennung wichtig sind
Tomate (Solanum lycopersicumDie Tomate ist die am häufigsten erforschte Gemüsepflanze in der Pflanzenpathologie, und die wirtschaftliche Rechtfertigung für diesen Forschungsschwerpunkt liegt auf der Hand. Die weltweite Tomatenproduktion erreichte 186 Millionen Tonnen im Jahr 2024, wobei China einen Beitrag leistet 37% des Gesamtertrags.
Die Pflanze dient der Lebensmittelverarbeitung, dem Frischmarkt und dem Anbau in Hausgärten auf allen Kontinenten. Allein in den Vereinigten Staaten überstieg der Produktionswert von Frischmarkttomaten im Jahr 2023 laut dem Landwirtschaftlichen Marktforschungszentrum mehrere Milliarden Dollar.
Blattkrankheiten stellen die größte Bedrohung für die Tomatenproduktion dar. Die Ernährungs- und Landwirtschaftsorganisation der Vereinten Nationen (FAO) schätzt, dass Pflanzenkrankheiten für etwa … verantwortlich sind. 40% Ernteverluste weltweit, was enorme Folgen für die Ernährungssicherheit und die Wirtschaft nach sich zieht.
Pilzkrankheiten allein verursachen jährliche Verluste in Höhe von $60 Milliarden weltweit. Insbesondere bei Tomaten kann die Bakterienfleckenkrankheit unter günstigen Bedingungen die Erträge um folgende Werte reduzieren: bis zu 90%, wodurch Erkennungs- und Reaktionszeit von entscheidender Bedeutung sind.

Die frühzeitige und präzise Erkennung von Krankheiten ist entscheidend. Ein Landwirt, der die Krautfäule im Anfangsstadium erkennt, kann sie durch gezielte Fungizidanwendungen eindämmen. Ein Landwirt, der die Krankheit erst bei sichtbarem Blattfall bemerkt, muss Ertragsverluste hinnehmen, die sich durch keine Maßnahme vollständig beheben lassen. Hier setzt künstliche Intelligenz an, insbesondere die intelligente Erkennung von Tomatenblattkrankheiten mittels Deep Learning.
Der breitere Kontext unterstützt diesen Wandel. Der globale Markt für KI in der Präzisionslandwirtschaft wurde auf folgende Summe geschätzt: $3,1 Milliarden im Jahr 2024 und wird voraussichtlich erreichen $12,7 Milliarden bis 2034 bei einem CAGR von 15,1% (Market.us, 2024). Intelligente Pflanzenschutzmittelüberwachung ist eines der am schnellsten wachsenden Segmente innerhalb dieser Expansion.
Tomatenblattkrankheiten: Ein Überblick für die Erkennungsarbeit
Bevor ein Erkennungssystem funktionieren kann, muss man genau verstehen, wonach es suchen soll. Tomatenblätter werden von einer Vielzahl von Krankheitserregern befallen, die jeweils unterschiedliche, aber manchmal überlappende visuelle Spuren hinterlassen.
1. Häufige Tomatenblattkrankheiten und ihre Erreger
Krautfäule, verursacht durch den Pilz Alternaria solani, verursacht dunkelbraune, konzentrische Ringläsionen an älteren Blättern. Die Ringe ähneln einem Zielscheibenmuster, und jede Läsion vergilbt, wenn das Gewebe abstirbt.
Krautfäule, verursacht durch den Eipilz Phytophthora infestans Derselbe Organismus, der auch die irische Kartoffelhungersnot verursachte, bildet wässrige, gräulich-grüne Flecken, die sich bei warmem, feuchtem Wetter rasch braun verfärben. Er breitet sich extrem schnell aus und kann innerhalb weniger Tage ein ganzes Feld vernichten.
Septoria-Blattflecken Es zeigt sich als kleine, kreisrunde Flecken mit dunkelbraunen Rändern und hellbraunen Zentren. Die Erkrankung beginnt typischerweise an den unteren Blättern und breitet sich nach oben aus; sie wird durch einen Pilz verursacht. Septoria lycopersici.
Bakterienfleck, verursacht durch Xanthomonas vesicatoria, Es entstehen kleine, wässrige Flecken, die braun und eckig werden und oft von gelben Höfen umgeben sind. Im Gegensatz zu Pilzflecken sprechen bakterielle Läsionen nicht auf Fungizidbehandlungen an.
Laubkompost, verursacht durch Passalora fulva, Die Krankheit zeigt sich als hellgrüne oder gelbe Flecken auf der Blattoberseite mit olivgrünem bis gräulich-violettem Schimmelbefall auf der Unterseite. Sie gedeiht in feuchten Gewächshausumgebungen.
Tomatenmosaikvirus (ToMV) Die Blätter weisen gesprenkelte hell- und dunkelgrüne Muster auf, oft begleitet von Blattkräuselung und Blasenbildung. Die unregelmäßige Farbverteilung unterscheidet sie von Nährstoffmangelerscheinungen.
Tomaten-Gelbblättrigkeitsvirus (TYLCV), übertragen durch die Weiße Fliege Bemisia tabaci, Sie verursacht ein Aufrollen der Blattränder, Vergilbung zwischen den Blattadern und starkes Wachstumshemmung. Sie zählt zu den wirtschaftlich schädlichsten Viruserkrankungen in warmen Tomatenanbaugebieten weltweit.
2. Krankheitssymptome und die zentrale Herausforderung der Früherkennung
Die visuelle Erkennung von Krankheiten stellt selbst für erfahrene Agronomen eine große Herausforderung dar. Frühstadien verschiedener Krankheiten können auf einem Smartphone-Foto nahezu identisch aussehen. Septoria-Blattflecken und Bakterienflecken verursachen beide kleine, runde Läsionen. Dürrfleckenkrankheit und Krautfäule führen beide zum Absterben von braunem Gewebe. Umweltfaktoren wie Stickstoffmangel, Kältestress und die Phytotoxizität von Pflanzenschutzmitteln können Virussymptome imitieren.
- Die Lichtverhältnisse bei der Bildaufnahme verändern dramatisch, wie Farbe und Textur der Läsionen erscheinen. Überbelichtete Fotos lassen die für die Früherkennung der Pilzinfektion entscheidenden Ringmuster verblassen.
- Mehrere Krankheiten können gleichzeitig auf einem einzigen Blatt auftreten, wobei sich die Symptome eines Krankheitserregers optisch mit denen eines anderen überlappen – ein Szenario, das sowohl menschliche Experten als auch KI-Modelle vor Herausforderungen stellt.
- Der Krankheitsverlauf verändert das Erscheinungsbild im Laufe der Zeit, was bedeutet, dass ein Modell, das nur auf fortgeschrittenen Läsionen trainiert wurde, oft die frühesten und am besten behandelbaren Infektionsstadien übersieht.
- Die Komplexität des Hintergrunds in Feldaufnahmen – Erde, andere Blätter, Früchte und Bewässerungsanlagen – führt zu visuellem Rauschen, das die Klassifizierungsgenauigkeit unter realen Bedingungen im Vergleich zu Laborbedingungen verschlechtert.
Dies sind nicht nur akademische Komplikationen. Sie beeinflussen unmittelbar, wie Erkennungsdatensätze erstellt, wie Modelle trainiert und wie Erkennungssysteme vor dem Einsatz validiert werden müssen.
Entscheidende Rolle der Früherkennung von Krankheiten im Pflanzenmanagement
Früherkennung bedeutet nicht einfach nur schnelleres Handeln. Es geht darum, zu handeln, solange die Wirkung noch anhält. Fungizide, die bei den ersten Anzeichen von Frühfäule eingesetzt werden, verhindern die Sporenbildung und die seitliche Ausbreitung. Dieselben Fungizide, die nach dem Blattfall (30%) angewendet werden, bringen wirtschaftlich kaum noch etwas.
- Ernteertrag Der unmittelbarste Nutzen besteht im Schutz: Auf Feldern, auf denen die Krankheit in den ersten 10 bis 14 Tagen nach Symptombeginn erkannt wird, sind die Ertragsverluste durchweg deutlich geringer als auf Feldern, auf denen die Erkennung um zwei oder mehr Wochen verzögert wird.
- Pestizideinsatz Die Reduzierung ergibt sich aus der präzisen zeitlichen Abstimmung. Anstatt Fungizide nach einem festen Zeitplan anzuwenden, können Landwirte mit Früherkennungsmöglichkeit diese nur dann einsetzen, wenn ein bestimmter Infektionsschwellenwert bestätigt ist, wodurch der Einsatz von Chemikalien um bis zu 40–50 µg/l reduziert wird.
- Kosteneinsparungen Die Schadstoffe sammeln sich während der Vegetationsperiode schnell an. Weniger Spritzvorgänge bedeuten weniger Arbeitsaufwand, Kraftstoff- und Chemikalienkosten. Für einen mittelgroßen Tomatenbetrieb mit über 50 Hektar Anbaufläche sind diese Einsparungen beträchtlich.
- Ziele für eine nachhaltige Landwirtschaft werden direkt unterstützt. Eine reduzierte Pestizidanwendung verringert den Abfluss in Gewässer und den Selektionsdruck für resistente Krankheitserregerstämme.
- Prävention der Krankheitsausbreitung Sie schützt nicht nur einzelne Felder, sondern ganze Landwirtschaftsregionen. Die Krautfäule beispielsweise erzeugt windverbreitete Sporen, die innerhalb weniger Stunden nach der Sporenbildung benachbarte Betriebe infizieren können.
Die ökonomische und agronomische Logik ist überzeugend: Investiert man in Früherkennungstechnologien, sinken die Folgekosten der Krankheitsbekämpfung deutlich.
Sánchez-Sánchez et al. (2024) schätzten, dass Viruserkrankungen allein den globalen Produktionswert von Tomaten um [Betrag einfügen] verringern. 2 bis 51 TP3T jährlich, Eine Zahl, die angesichts der weltweiten Marktgröße des Produkts Verluste in Milliardenhöhe von US-Dollar bedeutet.
Selbst eine geringfügige Reduzierung krankheitsbedingter Verluste durch frühzeitige KI-Erkennung kann für große Tomatenproduzenten innerhalb einer einzigen Anbausaison einen Return on Investment der Technologieinvestitionen erzielen.
Präzisionslandwirtschaft und intelligente Krankheitsüberwachungssysteme
Präzisionslandwirtschaft betrachtet einen landwirtschaftlichen Betrieb als ein Mosaik aus verschiedenen Zonen anstatt als einheitliches Feld. Anstatt auf jedem Quadratmeter die gleiche Saatmenge, Wassermenge oder Fungiziddosis anzuwenden, nutzen Präzisionssysteme Echtzeitdaten, um die Betriebsmittel an die tatsächlichen Bedingungen an jedem Standort anzupassen.
1. Kernkonzepte der Präzisionslandwirtschaft
Datengestützte Landwirtschaft basiert auf einem kontinuierlichen Kreislauf: Sensoren und Bildgebungssysteme erfassen Felddaten, Software verarbeitet und interpretiert diese Daten, und Entscheidungshilfen setzen die Interpretation in Handlungsempfehlungen um. Jedes Glied dieser Kette muss präzise sein, damit das System einen Mehrwert bietet.
Intelligentes Pflanzenmanagement überträgt diese Logik auf biologische Bedrohungen. Anstatt auf offensichtliche Krankheitssymptome zu warten oder sich auf wöchentliche Kontrollgänge zu verlassen, erkennt ein intelligentes Überwachungssystem Krankheiten beim ersten sichtbaren oder spektralen Anzeichen und löst eine Warnung aus, die Ort, Art und wahrscheinlichen Schweregrad des Befalls angibt.
2. Technologien zur Krankheitsüberwachung in der modernen Präzisionslandwirtschaft
Digitale Bildgebung bildet die Grundlage für die meisten intelligenten Systeme zur Krankheitserkennung. RGB-Kameras erfassen die für das menschliche Auge sichtbaren Farbinformationen. Multispektralkameras erfassen Wellenlängen jenseits des sichtbaren Lichts, einschließlich Nahinfrarot, wodurch Chlorophyllstress sichtbar wird, bevor er mit bloßem Auge erkennbar ist.
Hyperspektralkameras erfassen Hunderte von schmalen Wellenlängenbändern und können biochemische Veränderungen auf molekularer Ebene erkennen, sind aber für die meisten Einsätze in der Landwirtschaft noch zu teuer.

Bodenbasierte Sensoren und IoT-Netzwerke ergänzen die Bildgebung. Temperatur- und Feuchtigkeitssensoren innerhalb der Pflanzenbestände liefern Mikroklimadaten, die Aufschluss darüber geben, wann krankheitsfördernde Bedingungen entstehen.
Eine Periode anhaltender Blattnässe von mehr als 10 Stunden in Verbindung mit Temperaturen zwischen 18 und 22 °C ist ein bekanntes Auslösersignal für Krautfäule – ein IoT-System kann eine Warnung vor Krankheitsrisiken ausgeben, bevor überhaupt Läsionen auftreten.
Drohnen und unbemannte Luftfahrzeuge (UAVs) erweitern die Krankheitsüberwachung um eine räumliche Dimension, die bodengestützte Bildgebung nicht bieten kann. Ein mit einer Multispektralkamera ausgestattetes UAV kann ein 10 Hektar großes Tomatenfeld in weniger als 30 Minuten erfassen und eine georeferenzierte Krankheitsrisikokarte erstellen, die genau zeigt, welche Reihen und Zonen frühe Stressanzeichen aufweisen.
Dies ermöglicht die gezielte Behandlung von Risikobereichen anstelle von flächendeckenden Anwendungen. IoT-fähige Landwirtschaftssysteme integrieren all diese Datenströme in eine einheitliche Plattform und speisen Beobachtungen auf Feldebene in cloudbasierte Analyse- oder Edge-Computing-Knoten ein, wo Krankheitsklassifizierungsalgorithmen nahezu in Echtzeit ausgeführt werden.
Deep Learning zur Erkennung von Tomatenblattkrankheiten
Deep Learning ist ein Teilgebiet des maschinellen Lernens, bei dem Algorithmen lernen, Muster direkt aus Rohdaten – in diesem Fall Bildern – durch hierarchische Schichten mathematischer Transformationen zu extrahieren.
Der entscheidende Vorteil gegenüber klassischem maschinellem Lernen besteht darin, dass Deep Learning keinen menschlichen Experten benötigt, der manuell definiert, welche Merkmale (Formen, Texturen, Farbverläufe) in einem Bild eines erkrankten Blattes zu suchen sind. Der Algorithmus lernt diese Merkmale anhand von Trainingsbeispielen.
1. Grundlagen des Deep Learning für die Bildklassifizierung
Ein Künstliches neuronales Netzwerk (KNN) (Ein Rechensystem, das lose von biologischen Neuronen inspiriert ist) verarbeitet Eingangsdaten über Schichten von miteinander verbundenen Knoten.
Jede Verbindung besitzt ein numerisches Gewicht, das bestimmt, wie stark die Aktivierung eines Knotens den nächsten beeinflusst. Das Training des Netzwerks bedeutet, diese Gewichte mithilfe von gekennzeichneten Beispielen so lange anzupassen, bis die Vorhersagen des Netzwerks mit minimalem Fehler mit den korrekten Kennzeichnungen übereinstimmen.
A Faltungsneuronales Netzwerk (CNN) (Eine spezielle Architektur neuronaler Netze für Bilddaten) wendet mathematische Operationen, sogenannte Faltungen, auf ein Bild an. Dabei wird ein kleines Filterfenster – typischerweise 3×3 oder 5×5 Pixel groß – über das Bild verschoben und an jeder Position eine gewichtete Summe berechnet. Das Ergebnis ist eine Merkmalskarte, die lokale Muster wie Kanten, Texturen und Farbverläufe erfasst.
Durch das Stapeln mehrerer Faltungsschichten kann das Netzwerk zunehmend abstraktere Merkmale erlernen: Kanten in frühen Schichten, Formen in mittleren Schichten und krankheitsspezifische Muster in tieferen Schichten.

Dieses hierarchische Merkmalslernen ist genau das, was CNNs bei der Erkennung von Tomatenkrankheiten so leistungsstark macht. Der kreisförmige Rand einer Läsion, ihr interner Texturgradient, der sie umgebende gelbe Hof – all dies wird zu lernbaren Merkmalskombinationen in den verschiedenen Schichten des Netzwerks.
2. Warum Deep Learning traditionelle Methoden übertrifft
Herkömmliche maschinelle Lernverfahren zur Erkennung von Pflanzenkrankheiten erforderten von Fachexperten die manuelle Merkmalsentwicklung: das Extrahieren von Farbhistogrammen, das Berechnen von Texturdeskriptoren oder das Messen von Formparametern aus Blattbildern und die anschließende Eingabe dieser Werte in Klassifikatoren wie Support Vector Machines (SVMs). Dieser Prozess war arbeitsintensiv, abhängig von Fachwissen und fehleranfällig, wenn das Krankheitsbild von den Trainingsbedingungen abwich.
- Deep Learning extrahiert automatisch Merkmale und lernt direkt aus Pixeldaten ohne manuelle Merkmalsentwicklung – wodurch der Flaschenhals der von Experten definierten Deskriptoren beseitigt wird.
- Die Klassifizierungsgenauigkeit von Deep Learning übersteigt regelmäßig 95% und erreicht auf Benchmark-Datensätzen oft 99%+, verglichen mit einer Genauigkeit von 80-88% bei traditionellen SVM-basierten Ansätzen auf denselben Daten.
- Deep-Learning-Modelle skalieren effektiv auf große Datensätze. Mit zunehmender Anzahl annotierter Krankheitsbilder verbessert sich die Modellleistung, während traditionelle Methoden bei einer festen Anzahl an Merkmalsmengen ein Plateau erreichen.
Lobna et al. (2024) trainierten ein Capsule Neural Network auf einem umfangreichen Datensatz von 70.834 Bilder von Tomatenblättern und erreichte eine Klassifizierungsgenauigkeit von 96.39% über mehrere Krankheitskategorien hinweg übertrifft es die Standard-CNN-Baselines bei denselben Daten.
Große, vielfältige Datensätze in Kombination mit optimierten Architekturen liefern konstant Genauigkeitswerte, die die mit herkömmlichen Computer-Vision-Pipelines erreichbaren Werte übertreffen.
Einsatz von Geopard Agriculture zur Krankheitserkennung auf realen Feldern
Geopard Agriculture schafft genau diese Ebene. Die Präzisions-Scouting-Plattform verbindet Feldbeobachtung, Krankheitserkennung und Entscheidungsunterstützung zu einem einzigen Arbeitsablauf, den jeder Agronom oder Landwirt über ein Smartphone bedienen kann.
Was Geopard für das Krankheitsmanagement bei Tomaten bietet
Das intelligente Scouting-System von Geopard identifiziert die wertvollsten Bereiche Ihres Feldes für gezielte Kontrollen, anstatt jede Reihe gleichmäßig abzudecken. Es erkennt automatisch Anomalien im Feldaufgang und konzentriert die Kontrollen auf Zonen, in denen Krankheitsdruck oder Stress am wahrscheinlichsten auftreten.
Dies löst direkt das Problem der unzureichenden Feldabdeckung, das manuelle Kontrollprogramme auf großen Anbauflächen einschränkt. Die Plattform unterstützt die Erkennung und Protokollierung aller wichtigen Bedrohungskategorien im Feld, die für die Tomatenproduktion relevant sind:
- Erkennung von Pilzkrankheiten wie Krautfäule, Knollenfäule, Septoria-Blattfleckenkrankheit und Blattschimmel – Krankheiten, bei denen der Zeitpunkt der Erkennung am unmittelbarsten darüber entscheidet, ob eine Behandlung erfolgreich ist.
- Identifizierung bakterieller und viraler Erkrankungen, einschließlich der Symptome von Bakterienfleckenkrankheit und Mosaikvirus, mit Fotodokumentation in Verbindung mit GPS-Koordinaten zur präzisen Kartierung im Gelände.
- Erkennung von Bewässerungs- und Düngungsproblemen, wodurch Scouting-Teams Symptome von abiotischem Stress erkennen können, die Krankheitssymptome in Tomatenbeständen imitieren oder verstärken können.
- Die Identifizierung von Unkräutern und Insekten erfolgt parallel zur Krankheitsüberwachung, sodass ein einziger Feldrundgang ein vollständiges Bedrohungsbild liefert und nicht isolierte Berichte aus verschiedenen Programmen.
- Unterstützung bei der Probenahme von Blattschäden und Gewebe, wodurch die Integration der physikalischen Laborprobenahme in den digitalen Scouting-Workflow ermöglicht wird.
Die Zonenplanung ist in die Vorbereitungsphase der Feldbegehung integriert. Geopard wandelt Rohdaten von Feldsensoren und Satelliten in kontinuierliche Gradientenkarten um, die die Heterogenität des Feldes visualisieren. So können Agronomen Bewirtschaftungszonen definieren, bevor die Feldbegehung beginnt. Offline-Zonenkarten und Bodendaten sind auch ohne Internetverbindung zugänglich, was insbesondere auf Betrieben mit unzuverlässiger Mobilfunkabdeckung wichtig ist.
Mobile Ausführung, Berichterstattung und Notfallwarnungen
Alle Feldbeobachtungen werden über die Geopard-Mobil-App erfasst. Pfadfinder zeichnen Notizen, Fotos und georeferenzierte Beobachtungen in Echtzeit auf, und die abgeschlossenen Pfadfinderberichte fließen direkt in das Berichts-Dashboard der Plattform ein.

Die Einsatzleiter können sehen, welche Bedrohungen identifiziert wurden, wo sie gefunden wurden, welche Maßnahmen ergriffen wurden und welche Zonen weiterhin überwacht werden – ohne Daten aus Papierformularen oder separaten Apps zusammenführen zu müssen.
Das Notfallwarnsystem überwacht die Ausbreitungsmuster von Krankheiten im gesamten Netzwerk der Plattform und benachrichtigt Sie, sobald der Krankheitsdruck in Ihrer Region zunimmt. Diese Frühwarnfunktion erweitert das effektive Erkennungsfenster über die Möglichkeiten der internen Kontrollen einzelner Betriebe hinaus und gibt Landwirten Vorlaufzeit, um präventive Maßnahmen vorzubereiten, bevor die Krankheit ihre Felder erreicht.
Der Ansatz von Geopard demonstriert den praktischen Integrationsweg, den Forscher im Bereich der Präzisionslandwirtschaft in der Theorie beschreiben: Satelliten- und Sensordaten zur Priorisierung der Erkundung, mobile Werkzeuge zur Erfassung von Echtzeitbeobachtungen und KI-gestützte Bedrohungserkennung zur Unterstützung einer schnelleren und gezielteren Entscheidungsfindung auf Betriebsebene.
Datensatzvorbereitung als Grundlage für das Erkennungsmodell
Ein Deep-Learning-Modell ist nur so zuverlässig wie die Daten, mit denen es trainiert wurde. Die Aufbereitung von Datensätzen zur Erkennung von Tomatenblattkrankheiten ist ein mehrstufiger Prozess, der die maximale Leistungsfähigkeit eines jeden Modells in der Praxis bestimmt.
1. Bildaufnahmequellen
Feldaufnahmen, die unter realen landwirtschaftlichen Bedingungen – mit wechselnder Beleuchtung, teilweiser Verdeckung, Wassertropfen und Bodenhintergrund – entstanden sind, stellen den Goldstandard für die Vielfalt der Datensätze dar, obwohl sie schwieriger und teurer zu erheben sind als Aufnahmen aus kontrollierten Umgebungen.
Smartphone-Bilder, die Landwirte bei routinemäßigen Kontrollgängen aufnehmen, bilden zunehmend eine praktische Datenquelle, die die Lücke zwischen Laborbedingungen und realen Einsatzszenarien schließt.
Öffentliche Datensätze haben die Forschung erheblich beschleunigt. PlantVillage-Datensatz, entwickelt von der Penn State University, enthält über 54.000 Bilder von gesunden und kranken Pflanzenblättern aus 26 Arten, darunter 10 Tomatenkrankheitskategorien.
Es diente als Trainingsgrundlage für Hunderte von veröffentlichten Modellen zur Erkennung von Tomatenkrankheiten und ist nach wie vor der am weitesten verbreitete Benchmark-Datensatz auf diesem Gebiet.
2. Schritte der Datenvorverarbeitung
Rohbilder aus verschiedenen Quellen enthalten Rauschen, uneinheitliche Größen und Farbkalibrierungsunterschiede, die zu fehlerhaften Mustern im Modelltraining führen können. Die Vorverarbeitung standardisiert die Daten, bevor sie dem Modell zugeführt werden.
- Durch die Bildskalierung werden alle Bilder auf eine einheitliche Auflösung skaliert – typischerweise 224×224 oder 256×256 Pixel für CNN-Architekturen – wodurch sichergestellt wird, dass räumliche Operationen innerhalb des Netzwerks einheitlich auf alle Trainingsbeispiele angewendet werden.
- Bei der Rauschunterdrückung werden Glättungsfilter wie Gaußsche Unschärfe eingesetzt, um Sensorrauschen und JPEG-Komprimierungsartefakte zu reduzieren, die texturempfindliche Faltungsschichten in die Irre führen können.
- Durch Datenaugmentation wird der Trainingsdatensatz künstlich erweitert, indem zufällige horizontale Spiegelungen, Drehungen, Farbveränderungen, Helligkeitsanpassungen und zufällige Beschneidungen auf vorhandene Bilder angewendet werden. Dies lehrt das Modell, Krankheitsmuster unabhängig von Blattausrichtung, Beleuchtungswinkel oder Bildkomposition zu erkennen.
- Die Normalisierung skaliert Pixelwerte von ihrem ursprünglichen Bereich von 0 bis 255 auf einen kleineren Bereich, typischerweise 0 bis 1 oder Mittelwert Null und Einheitsvarianz. Dadurch wird das gradientenbasierte Training numerisch stabiler und konvergiert schneller.
3. Annotation und Beschriftung des Datensatzes
Jedes Bild in einem Datensatz für überwachtes Lernen muss eine korrekte Kennzeichnung enthalten: die Krankheitskategorie, zu der es gehört, oder ob das Blatt gesund ist. Diese Kennzeichnung muss von Pflanzenpathologen und nicht nur von landwirtschaftlichen Allgemeinexperten vorgenommen oder validiert werden, da die visuelle Überlappung zwischen Krankheiten die Annotation durch Laien unzuverlässig macht.
Die Annotation auf Klassenebene für die Krankheitsklassifizierung ist relativ unkompliziert, aber die Begrenzungsrahmenannotation für Objekterkennungsmodelle – die genau markiert, wo die Läsion im Bild erscheint – erfordert deutlich mehr Zeit und Fachwissen pro Bild.
Deep-Learning-Architekturen zur Erkennung von Tomatenkrankheiten
Die Forschungsgemeinschaft hat Dutzende von Architekturen zur Klassifizierung von Tomatenblattkrankheiten evaluiert. Das Verständnis, welche Architekturen dominieren und warum, hilft Anwendern, fundierte Entscheidungen beim Einsatz dieser Systeme zu treffen.
1. Standardmäßige Convolutional Neural Networks
Grundlegende CNN-Modelle für die Krankheitsklassifizierung folgen einem Standardmuster: Faltungsschichten zur Merkmalsextraktion, Pooling-Schichten, die die räumlichen Dimensionen reduzieren und gleichzeitig dominante Merkmale beibehalten, und vollständig verbundene Schichten am Ende, die die extrahierten Merkmale den Wahrscheinlichkeiten der Krankheitsklassen zuordnen.
Frühere Arbeiten mit dem PlantVillage-Datensatz zeigten, dass selbst bescheidene CNNs mit 5-7 Schichten eine Genauigkeit von über 90% bei sauberen, im Labor aufgenommenen Bildern erreichen konnten.
2. Transferlernen mit vortrainierten Architekturen
Transferlernen Die Praxis, mit einem Modell zu beginnen, das auf einem großen allgemeinen Datensatz vortrainiert wurde, und es dann auf einem domänenspezifischen Datensatz feinabzustimmen, hat die Forschung zur Erkennung von Tomatenkrankheiten revolutioniert, indem sie es ermöglichte, hochpräzise Modelle mit relativ kleinen landwirtschaftlichen Datensätzen zu trainieren.
1. VGG16 und VGG19, Die von der Visual Geometry Group in Oxford entwickelten Modelle verwenden 16 oder 19 Gewichtungsebenen mit einheitlichen 3×3-Faltungen. Sie gelten weiterhin als zuverlässige Basismodelle für die Klassifizierung von Tomatenkrankheiten und erreichen nach Feinabstimmung anhand von Krankheitsdatensätzen typischerweise eine Genauigkeit von 94–971 TP3T.
2. ResNet Das Residualnetzwerk führte Skip-Verbindungen ein, die es ermöglichen, Gradienten direkt zwischen den Schichten fließen zu lassen und so das Problem des verschwindenden Gradienten zu lösen, das die Trainingstiefe zuvor begrenzte. ResNet50, feinabgestimmt auf Daten zu Tomatenkrankheiten, erreicht in aktuellen Studien durchweg eine Genauigkeit von 96–981 TP3T.
3. DenseNet erweitert das Skip-Connection-Konzept, indem jede Schicht mit jeder nachfolgenden Schicht in einem dichten Block verbunden wird, wodurch die Wiederverwendung von Merkmalen maximiert und kompakte Modelle mit starker Klassifizierungsleistung erzeugt werden.
4. EfficientNet, EfficientNetB0, entwickelt von Google Brain, skaliert Netzwerkbreite, -tiefe und -auflösung gleichzeitig mithilfe eines zusammengesetzten Koeffizienten. EfficientNetB0 mit einem Aufmerksamkeitsmodul erreichte dies. 99,39% Genauigkeit zur Klassifizierung von Pflanzenkrankheiten in einer von González-Briones et al. (2025) veröffentlichten Studie, mit einer für den Einsatz auf Edge-Geräten geeigneten Leistung.
5. MobileNet, das speziell für ressourcenbeschränkte Geräte entwickelt wurde, verwendet tiefenweise separierbare Faltungen, um den Rechenaufwand drastisch zu reduzieren und gleichzeitig eine hohe Genauigkeit zu gewährleisten – was es zur bevorzugten Architektur für den Einsatz von KI auf Smartphones und Edge-Geräten in der Präzisionslandwirtschaft macht.
3. Hybrid- und Advanced-Modelle
Die jüngsten Forschungen gehen über herkömmliche CNNs hinaus und entwickeln Architekturen, die räumliche Beziehungen über größere Entfernungen in Blattbildern erfassen können.
Vision Transformers (ViT) (Neuronale Netze, die den ursprünglich für die Verarbeitung natürlicher Sprache entwickelten Transformer-Aufmerksamkeitsmechanismus auf Bildausschnitte anwenden) haben bei der Erkennung von Pflanzenkrankheiten starke Ergebnisse gezeigt, wenn ausreichend Trainingsdaten verfügbar sind.
Im Gegensatz zu CNNs, die lokale Bildregionen durch Faltungen verarbeiten, lernen ViTs gleichzeitig Beziehungen zwischen allen Bildausschnitten, wodurch sie räumlich verteilte Muster über ein ganzes Blatt hinweg erkennen können.

Aufmerksamkeitsbasierte CNN-Hybride Die Stärke der lokalen Merkmalsextraktion durch Faltungen wird mit Aufmerksamkeitsmechanismen kombiniert, die es dem Modell ermöglichen, die Verarbeitungsressourcen auf die krankheitsrelevantesten Bildregionen zu konzentrieren.
Ein auf einem siamesischen Netzwerk basierendes, leichtgewichtiges Framework zur Erkennung von Tomatenkrankheiten wurde erreicht 96,97% Genauigkeit bei der Tomaten-Teilmenge Plant Village mit nur etwa 2,96 Millionen Parametern (Frontiers in Plant Science, 2025), was zeigt, dass hohe Genauigkeit und Hardwareeffizienz keine sich gegenseitig ausschließenden Ziele sind.
Ensemble-Lernmodelle Durch die Kombination von Vorhersagen mehrerer unabhängig trainierter Architekturen mittels Mittelwertbildung oder Abstimmung wird eine robustere Gesamtvorhersage erzielt als jedes einzelne Modell. Wu et al. (2024) nutzten ResNet50 mit Techniken zur Merkmalserweiterung, um mit diesem Ansatz eine verbesserte Klassifizierungsleistung zu erreichen.
Abdullah et al. (Agronomie, 2024) verglichen YOLOv8s, YOLOv5 und Faster R-CNN zur Erkennung kranker Tomatenblätter und stellten fest, dass YOLOv8s eine mittlere durchschnittliche Präzision (mAP) von 92.5%, und übertrifft damit YOLOv5 mit 89,1% und Faster R-CNN mit 77,5%, während es gleichzeitig eine schnellere Inferenzgeschwindigkeit und einen geringeren Modell-Footprint aufweist.
Für Echtzeit-Erkennungsanwendungen im Feld bieten Modelle der YOLOv8-Klasse die beste Balance zwischen Genauigkeit und Verarbeitungsgeschwindigkeit und eignen sich daher hervorragend für den Einsatz auf Drohnen oder Edge-Geräten.
Intelligentes Rahmenwerk zur Krankheitserkennung
Ein einsetzbares intelligentes Krankheitserkennungssystem ist mehr als ein trainiertes Modell. Es ist eine durchgängige Pipeline, die von der Rohbildaufnahme bis hin zu umsetzbaren Empfehlungen für das Krankheitsmanagement reicht.
1. Systemarchitektur
Die Kernpipeline besteht aus fünf aufeinanderfolgenden Stufen, in denen die Daten jeweils transformiert werden, bevor sie an die nächste Stufe weitergegeben werden.
1. Die Bildeingabe akzeptiert Rohbilder von Blättern aus beliebigen Aufnahmequellen – sei es ein Smartphone im Feld, eine an einer Drohne montierte Kamera oder eine fest installierte Kamera in einem Gewächshaus. Module zur Eingabeverarbeitung prüfen die Bildauflösung und kennzeichnen unscharfe oder unbrauchbare Aufnahmen, bevor diese in die Verarbeitungskette gelangen.
2. In der Vorverarbeitungsphase werden die in Abschnitt 6.2 beschriebenen Schritte zur Normalisierung, Größenänderung und Qualitätsverbesserung angewendet, um sicherzustellen, dass die Eingabe dem vom trainierten Modell erwarteten Format entspricht.
3. Die Merkmalsextraktion leitet das vorverarbeitete Bild durch die Faltungsschichten des trainierten Deep-Learning-Modells. In diesem Schritt transformiert das Modell die Rohpixeldaten in eine kompakte numerische Repräsentation (einen Merkmalsvektor), die die krankheitsrelevanten visuellen Merkmale des Blattes kodiert.
4. Die Krankheitsklassifizierung wendet die vollständig verbundenen Schichten und die Softmax-Ausgabefunktion auf den Merkmalsvektor an und berechnet für jede Krankheitskategorie einen Wahrscheinlichkeitswert. Die Kategorie mit der höchsten Wahrscheinlichkeit wird zur vorhergesagten Diagnose.
5. Die Entscheidungsunterstützung übersetzt das Klassifizierungsergebnis in eine praktische Empfehlung: den identifizierten Krankheitsnamen, das Konfidenzniveau, die vorgeschlagene Managementmaßnahme (gezieltes Fungizid, biologisches Bekämpfungsmittel, Entfernung befallener Pflanzen) und georeferenzierte Standortdaten, falls das Bild mit einem GPS-fähigen Gerät aufgenommen wurde.
2. Arbeitsablauf eines kompletten Detektionssystems in der Praxis
In der Praxis öffnet ein Landwirt eine mobile Anwendung und fotografiert ein befallenes Blatt. Das Bild wird entweder an einen Cloud-Server gesendet, auf dem das Erkennungsmodell ausgeführt wird, oder lokal auf dem Gerät mithilfe eines komprimierten Edge-Modells verarbeitet.
Innerhalb weniger Sekunden liefert die App eine Diagnose: “Dursche Krautfäule – 94%-Konfidenz. Empfohlene Maßnahme: Fungizid auf Mancozeb-Basis mit 1,5 kg/ha auf die betroffene Fläche ausbringen.“.
”Beobachten Sie die benachbarten Pflanzen in den nächsten 5 Tagen.“ Das georeferenzierte Ergebnis wird in der digitalen Gesundheitskarte des Betriebs protokolliert, und wenn dieselbe Krankheit in mehreren Zonen auftritt, gibt das System eine Warnung vor erhöhtem Risiko für den gesamten Feldblock aus.
Demilie (2024), Rezension 161 Veröffentlichungen Eine Studie zur Erkennung von Pflanzenkrankheiten mittels Deep Learning ergab, dass die Tomate die am häufigsten untersuchte Kulturpflanze in allen Studien war und einen Anteil von ... ausmachte. 39% aller Veröffentlichungen — mehr als doppelt so viel wie bei der zweithäufigsten untersuchten Kulturpflanze (Reis bei 16%), was die einzigartige Überschneidung von wirtschaftlicher Bedeutung und Krankheitsanfälligkeit dieser Kulturpflanze bestätigt.
Der hohe Reifegrad der Forschung zur Erkennung von Tomatenkrankheiten bedeutet, dass Anwender auf eine breite Palette validierter Architekturen und vortrainierter Modelle zugreifen können, anstatt von Grund auf neu zu beginnen.
Leistungsbewertungsmetriken
Die Wahl der richtigen Bewertungsmetrik ist genauso wichtig wie die Wahl der richtigen Architektur, insbesondere bei der Krankheitserkennung, wo falsch negative Ergebnisse (das Übersehen einer tatsächlichen Krankheit) andere Kosten verursachen als falsch positive Ergebnisse (die fälschliche Identifizierung eines gesunden Blattes als krank).
Genauigkeit Sie misst den Anteil aller korrekten Vorhersagen. Sie ist die am häufigsten verwendete Kennzahl, kann aber irreführend sein, wenn Krankheitsklassen unausgewogen sind – ein Modell, das in einem Datensatz mit 901.030 gesunden Bildern immer “gesund” vorhersagt, erreicht zwar eine Genauigkeit von 901.030, ist aber für die Krankheitserkennung völlig unbrauchbar.
Präzision Es misst den Anteil tatsächlich positiver Krankheitsfälle unter den erfassten Daten und erfasst die Rate falsch-positiver Befunde. Die hohe Präzision führt dazu, dass das Modell nur selten unnötige Behandlungsempfehlungen ausgibt.
Erinnerung (Sensitivität) Misst, welcher Anteil tatsächlich erkrankter Pflanzen korrekt als erkrankt erkannt wird. Eine hohe Trefferquote bedeutet, dass das Modell echte Infektionen selten übersieht – die wichtigere Kennzahl für das Krankheitsmanagement.
F1-Score Die Präzision ist das harmonische Mittel aus Präzision und Trefferquote und liefert ein ausgewogenes Maß, das Modelle bestraft, die eines der beiden zugunsten des anderen opfern. Sie ist die bevorzugte Metrik, wenn sowohl falsch positive als auch falsch negative Ergebnisse relevante Kosten verursachen.
Spezifität misst, wie genau das Modell wirklich gesunde Blätter als gesund erkennt, was wichtig ist, um unnötige Pestizidanwendungen auf krankheitsfreien Nutzpflanzen zu vermeiden.
Die Konfusionsmatrix zeigt die vollständige Aufschlüsselung der Vorhersagen über alle Klassen hinweg und enthüllt, welche Krankheitspaare am häufigsten verwechselt werden – wichtige Informationen zur Verfeinerung der Trainingsdaten oder der Modellarchitektur.
Die ROC-AUC (Receiver Operating Characteristic — Fläche unter der Kurve) misst die Gesamtunterscheidbarkeit des Modells über alle Klassifizierungsschwellenwerte hinweg, wobei ein Wert von 1,0 eine perfekte Unterscheidung und 0,5 eine Leistung auf Zufallsniveau darstellt.
Echtzeit-Krankheitserkennung bei Tomaten: Einsatz
Die Übertragung eines hochpräzisen Modells von einem Forschungslabor in ein produktives landwirtschaftliches System erfordert die Lösung anderer Probleme als das Modelltraining. Einsatzumgebungen unterliegen Hardwarebeschränkungen, eingeschränkter Konnektivität und Latenzanforderungen, die die Wahl der Architektur und Infrastruktur beeinflussen.
1. Smartphone-basierte Anwendungen zur mobilen Krankheitsdiagnose
Smartphone-Apps stellen für Klein- und Mittelbauern den einfachsten Weg zur Datenerfassung dar. Apps, die auf MobileNet- oder EfficientNet-Lite-Modellen basieren, führen die Datenanalyse vollständig lokal auf dem Gerät durch und benötigen daher zum Zeitpunkt der Datenerfassung keine Internetverbindung.
Das präziseste Modell ist in der Präzisionslandwirtschaft wertlos, wenn es nicht auf dem Gerät laufen kann, das der Landwirt bereits in der Tasche hat.
Dies ist für landwirtschaftliche Betriebe in ländlichen Gebieten oder Regionen mit schlechter Internetanbindung von enormer Bedeutung. Der Landwirt fotografiert ein verdächtiges Blatt, erhält innerhalb von 1–3 Sekunden eine Krankheitsprognose und trägt das Ergebnis in eine Datenbank ein, die betriebsweite Gesundheitsdaten während der gesamten Vegetationsperiode erfasst.
2. Edge-KI-Implementierung: Geräteinterferenz
Edge-KI Die direkte Ausführung von KI-Inferenz auf Hardware am Datenerfassungspunkt anstatt der Datenübertragung an einen entfernten Server löst die Latenz- und Verbindungsprobleme cloudbasierter Erkennung. Spezielle Edge-Geräte wie die NVIDIA Jetson-Serie oder Googles Coral TPU-Beschleuniger können komprimierte CNN-Modelle mit über 30 Bildern pro Sekunde ausführen und ermöglichen so die kontinuierliche Echtzeit-Blattüberwachung durch fest installierte Kameras an Gewächshausschienen oder Feldbewässerungsanlagen.
Modellkomprimierungstechniken – Quantisierung (Verringerung der numerischen Genauigkeit der Modellgewichte), Pruning (Entfernung von Netzwerkverbindungen mit geringer Bedeutung) und Wissensdestillation (Training eines kleinen Modells zur Nachahmung eines großen Modells) – ermöglichen dies, ohne die akzeptable Genauigkeit zu beeinträchtigen.
3. Drohnenbasierte Überwachungssysteme für die großflächige landwirtschaftliche Überwachung
Bei landwirtschaftlichen Betrieben mit mehr als 20–30 Hektar Fläche reicht die bodengestützte Inspektion nicht aus, um Krankheitsausbrüche frühzeitig zu erkennen und ihre Ausbreitung zu verhindern. UAV-Systeme mit Multispektralkameras erfassen hingegen die Stresssignale von Krankheiten auf der gesamten Fläche.
Die aufgenommenen Bilder werden an einen Onboard-Prozessor weitergeleitet oder an eine Bodenstation übertragen, wo das Erkennungsmodell infizierte Zonen identifiziert und eine georeferenzierte Karte generiert, die über die digitalen Parzellenaufzeichnungen des landwirtschaftlichen Betriebs gelegt wird.
Dadurch verschiebt sich der Fokus des Krankheitsmanagements von reaktiv (Reaktion nach dem Auftreten offensichtlicher Symptome) hin zu räumlich proaktiv (Reaktion auf spezifische Feldkoordinaten, an denen frühzeitiger Stress festgestellt wird).
Herausforderungen bei der auf Deep Learning basierenden Krankheitserkennung
Das Gebiet hat bemerkenswerte Fortschritte gemacht, doch eine ehrliche Einschätzung der verbleibenden Herausforderungen beugt übermäßigem Selbstvertrauen bei den Einsatzentscheidungen vor.
Beschränkte Felddatensätze Das größte Problem bleibt die mangelnde Genauigkeit. Die meisten hochpräzisen Modelle werden auf PlantVillage trainiert und evaluiert, das mit kontrollierter Beleuchtung und Einzelblattaufnahmen vor neutralem Hintergrund arbeitet. Die Leistung im realen Feld sinkt deutlich, wenn dieselben Modelle mit komplexen, mehrdimensionalen Bildern unter variablen Lichtverhältnissen konfrontiert werden.
Schwankungen der Lichtverhältnisse — direktes Sonnenlicht, das spiegelnde Reflexionen auf der Blattoberfläche verursacht, diffuses Licht bei Bewölkung, das die Texturmerkmale abflacht, oder Schattenwurf durch das Blätterdach der Pflanzen — verändern die scheinbare Farbe und Textur der Läsionen auf eine Weise, die die Klassifizierung im Vergleich zu kontrollierten Bedingungen um 5 bis 15 Prozentpunkte verschlechtern kann.
Hintergrundkomplexität Die Verwendung von Feldaufnahmen führt zu irrelevanten visuellen Informationen. Erde, Mulch, Bewässerungsleitungen, Früchte und andere Blätter können alle im selben Bildausschnitt wie ein krankes Blatt erscheinen, und Modelle, die nicht speziell für komplexe Hintergründe trainiert wurden, verwechseln Hintergrundelemente oft mit Krankheitsmerkmalen.
Mehrere Krankheiten Die Klassifizierung eines einzelnen Blattes stellt eine Herausforderung dar, für die die meisten Single-Label-Modelle nicht ausgelegt sind. Ein Blatt, das gleichzeitig Bakterienfleckenkrankheit und Dürrfleckenkrankheit aufweist, erfordert eine Multi-Label-Klassifizierung, was die Komplexität des Trainings und den Aufwand für die Datensatzannotation erhöht.
Klassenungleichgewicht Bei Trainingsdatensätzen – die weitaus mehr Bilder von häufigen Krankheiten wie der Krautfäule als von seltenen Krankheiten wie dem Mosaikvirus enthalten – führt dies dazu, dass Modelle bei häufigen Klassen zu selbstsicher und bei weniger vertretenen Klassen unzuverlässig sind.
Modellinterpretierbarkeit stellt ein erhebliches Hindernis für das Vertrauen in landwirtschaftliche Betriebe dar. Wenn ein Modell ein Blatt mit einer Konfidenz von 97% als krank einstuft, möchten die meisten Landwirte und Agronomen verstehen, welche visuellen Merkmale zu dieser Entscheidung geführt haben, bevor sie der Empfehlung folgen.
Neueste Fortschritte bei der intelligenten Krankheitserkennung
Die Forschung bewegt sich gleichzeitig auf mehreren Ebenen und befasst sich mit verschiedenen Aspekten der oben beschriebenen Herausforderung.
1. Erklärbare KI (XAI) Werkzeuge – insbesondere Grad-CAM (Gradient-weighted Class Activation Mapping), das Heatmap-Überlagerungen erzeugt, die zeigen, auf welche Bereiche eines Blattbildes sich das Modell bei der Entscheidungsfindung konzentriert hat – gehen direkt auf das Interpretierbarkeitsproblem ein.
Eine Grad-CAM-Visualisierung, die zeigt, dass die Aufmerksamkeit des Modells auf einen dunklen Läsionsring konzentriert ist, liefert eine Form der Rechtfertigung, die Agronomen bewerten und der sie vertrauen können.
2. Vision Transformers (ViT) ViT gewinnt weiterhin an Bedeutung für die Erkennung von Tomatenkrankheiten, da sich die Vortrainingsstrategien verbessern und der Datenbedarf für die ViT-Feinabstimmung sinkt.
Ihre Fähigkeit, globale Muster auf Blattebene anstatt rein lokaler Merkmale zu erfassen, macht sie besonders vielversprechend für die Erkennung von Viruserkrankungen, die die gesamte Blattoberfläche betreffen, anstatt lokalisierte Läsionen hervorzurufen.
3. Föderiertes Lernen Das Problem der Felddatensätze wird dadurch gelöst, dass Modelle kollaborativ über mehrere landwirtschaftliche Betriebe hinweg trainiert werden können, ohne sensible Daten zentral zu speichern.
Jeder Betrieb trainiert ein lokales Modell mit seinen eigenen Bildern, und nur die Modellparameter-Aktualisierungen (nicht die Bilder selbst) werden geteilt, um ein zentrales globales Modell zu verbessern. Dies wahrt die Datenprivatsphäre der Landwirte und erweitert gleichzeitig die Vielfalt der Trainingsdaten erheblich.
Präzisionskrankheitsmanagement wird nicht durch die Genauigkeit eines einzelnen Modells definiert, sondern durch die Intelligenz des Systems, das Erkennung, Entscheidung und Handlung miteinander verbindet.
4. Selbstüberwachtes Lernen Modelle werden zunächst anhand großer Sammlungen unbeschrifteter Pflanzenbilder vortrainiert, um allgemeine visuelle Repräsentationen zu erlernen, und anschließend anhand kleiner, beschrifteter Krankheitsdatensätze feinabgestimmt. Dies reduziert den Annotationsaufwand und ermöglicht die Entwicklung hochwertiger Modelle für Krankheitskategorien, für die nur wenige beschriftete Beispiele vorliegen.
5. Multimodale Krankheitserkennung Das System integriert Blattbilddaten mit spektralen Sensormesswerten, Wetterstationsdaten und historischen Krankheitsdaten in einen einheitlichen Modelleingang. Die Kombination visueller und umweltbezogener Daten kann die Erkennungsleistung über die Möglichkeiten von Bilddaten allein hinaus verbessern, insbesondere bei Krankheiten, deren visuelle Symptome von biochemischen Veränderungen begleitet werden, die in spektralen Signaturen nachweisbar sind.
Zukünftige Forschungsrichtungen: Was das Fachgebiet noch benötigt
Die Übertragung hochpräziser Forschungsmodelle in eine durchweg zuverlässige Anwendung auf landwirtschaftlicher Ebene erfordert gezielte Anstrengungen an mehreren Fronten.
Validierung des Einsatzes in der Praxis Um die Leistungslücke zwischen der Erkennung unter kontrollierten Bedingungen und unter Feldbedingungen ehrlich zu charakterisieren, sind Untersuchungen in unterschiedlichen geografischen Regionen und landwirtschaftlichen Systemen erforderlich – nicht nur anhand der PlantVillage-Benchmarks.
Robuste Felddetektion Dies erfordert speziell erstellte Felddatensätze, die über mehrere Vegetationsperioden in verschiedenen Ländern hinweg erhoben werden, wobei die Wetterbedingungen zum Zeitpunkt der Bildaufnahme systematisch dokumentiert werden.
Integration mit IoT- und Smart-Farming-Infrastruktur — Durch die direkte Verknüpfung von Krankheitserkennungsalarmen mit automatisierten Bewässerungs- und Düngesystemen, Drohnen-Sprühplattformen und landwirtschaftlicher Managementsoftware — wird der Regelkreis zwischen Erkennung und Reaktion geschlossen.
Vorhersage von Krankheiten, Die Kombination aktueller Daten zur Krankheitserkennung mit Wettervorhersagemodellen und historischen Ausbreitungsmustern von Krankheiten wird den Paradigmenwechsel von der reaktiven Erkennung hin zum vorausschauenden Management ermöglichen: die Empfehlung von Präventivmaßnahmen, bevor Symptome auftreten.
Autonome Agrarsysteme — UAV-Flotten, die eine kontinuierliche Feldüberwachung durchführen, Krankheitszonen kennzeichnen und sich ohne menschliches Eingreifen mit automatisierten Sprüheinheiten koordinieren — stellen den Horizont dar, auf den die aktuelle Präzisionslandwirtschaftstechnologie hinarbeitet.
Schlussfolgerung
Die intelligente Erkennung von Tomatenblattkrankheiten mittels Deep Learning ist längst keine experimentelle Technologie mehr. Es handelt sich um eine ausgereifte, gut validierte Anwendung, deren Fähigkeit zur präzisen, schnellen und kostengünstigen Identifizierung von Tomatenkrankheiten durch eine wachsende Zahl von Fachartikeln bestätigt wird. Von einfachen CNN-Modellen, die mit dem PlantVillage-Datensatz trainiert wurden, bis hin zu aufmerksamkeitsbasierten Hybridarchitekturen mit einer Genauigkeit von über 99% übertrifft das technische Potenzial mittlerweile die für die meisten landwirtschaftlichen Betriebe verfügbare Infrastruktur.
Der Weg in die Zukunft ist klar. Präzisionslandwirtschaftssysteme, die bildbasierte Krankheitserkennung mit IoT-Sensornetzwerken, UAV-Überwachung und prädiktiven Wettermodellen integrieren, werden die Wettbewerbsfähigkeit der Tomatenproduktion innerhalb dieses Jahrzehnts prägen. Der Markt für KI in der Präzisionslandwirtschaft wächst rasant. CAGR von 15,1% zu $12,7 Milliarden bis 2034 Dies deutet darauf hin, dass diese Investition bereits in großem Umfang angelaufen ist.


 English
 German
 Ukrainian
 French
 Kazakh
 Portuguese
 Spanish
 Arabic
 Swedish
 Serbian
 Romanian
 Norwegian
 Finnish
 Lithuanian
 Estonian
 Latvian
 Croatian
 Slovenian
 Slovak
 Japanese
 Polish
